


准确率超过96%!蚂蚁数科AiWork 数据智能体刷新国际Data Agent榜单新纪录
近日,蚂蚁数科技术团队提交的 Data Agent 方案,登顶国际数据智能体评测基准 Data Agent Bench(DAB),并以 96.3% 的准确率刷新该榜单历史纪录。这意味着,在高度贴近真实企业场景的复杂数据分析任务中,蚂蚁数科的数据智能体具备领先的理解与分析能力,也折射出数据智能体正从“会答题”迈向“能交付”的新阶段。
值得一提的是,蚂蚁数科方案基于GLM-5.3和决策模型Jev1.13构建,超过了多个基于Claude和GPT模型的参评方案。相关能力已在蚂蚁数科 Agentar AiWork 产品体系中落地。
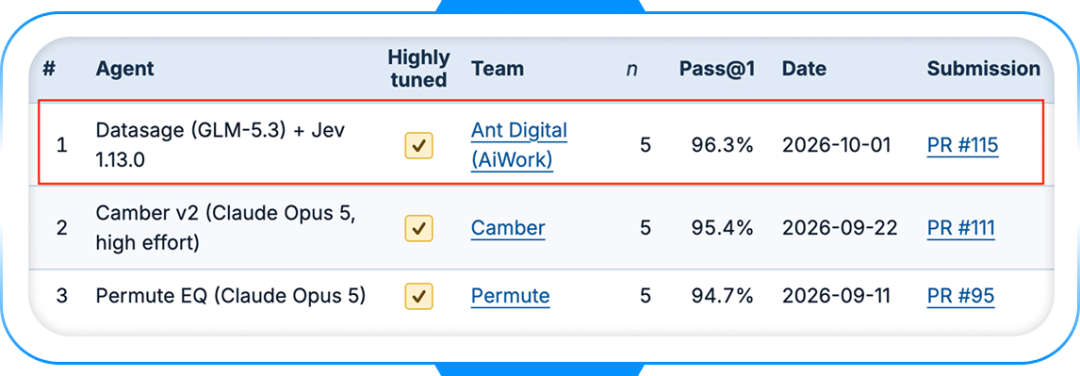
DAB由 UC Berkeley EPIC Data Lab 与 Hasura PromptQL 合作推出的数据智能体评测基准,旨在考察智能体处理复杂企业数据任务的能力。它覆盖本地商户、股票市场、客户关系管理等多个领域,并基于公开数据集模拟企业中常见的数据难点:数据分散在 PostgreSQL、MongoDB(MDB)、SQLite、DuckDB 等异构数据库中,同一实体的关联键名称或格式不一致,部分关键信息嵌入非结构化文本,回答问题还可能需要领域知识。
DAB官方链接:
https://ucbepic.github.io/DataAgentBench/
也就是说,它考察的不是“会不会写 SQL”,而是智能体能否像分析师一样,跨源找数、理解业务、完成判断,并稳定给出正确结果。
例如在本地生活场景中,题目可能要求智能体找出某个城市里“下班后仍营业、同时提供停车和 WiFi、且评分较高的商户”。要答对这样的问题,智能体不仅要跨库关联商户信息、评论数据和营业时间,还要处理数据清洗、时间语义解析,以及多条件筛选和评分聚合等难题。
此次蚂蚁数科登顶,靠的不是让大模型“自由发挥”,而是一套更适合企业场景的完整方案,其核心创新可以概括为:“本体驱动+工具协同+决策模型”。
其中,最关键的是本体层。企业里最常见的问题不是没数据,而是“同一句话,不同人理解不同”。比如“营收”“客户”“同比”“渗透率”这些词,在不同团队、不同系统里往往有不同口径。蚂蚁数科在数据与模型之间加入本体语义层,相当于先为 AI 建立一张“企业地图”, 帮助它理解企业内部的业务术语、指标口径和对象关系。
第二层是工具层。在实际分析中,大量环节并不需要模型创造性生成,而需要稳定、准确执行。比如同比环比计算、聚合、去重、排序等,蚂蚁数科将其沉淀为可复用工具,让智能体直接调用,减少计算误差,提高稳定性。
第三层是决策层。方案中引入了Jev决策模型,专门负责分类、选择和判断类任务。与通用大模型相比,这类模型更轻、更快,更适合处理高频判断任务。它能与大模型形成分工协同:高置信度任务快速处理,低置信度结果再交给大模型兜底。
目前,相关能力已在蚂蚁数科 AiWork DataAgent 产品体系中落地,对外服务零售、家居等多个行业客户。它能够帮助企业完成跨系统取数、经营指标分析、变化归因、辅助决策等任务,让数据分析从少数专业人员的工作,变成企业可随时调用的智能服务能力。
此前,蚂蚁数科的数据智能体曾在全球权威 NL2SQL(自然语言转 SQL)评测基准 BIRD-Bench 上登顶第一,执行准确率和执行效率两项核心指标均位列榜首,创下中国公司在该榜单上的最佳成绩。
未来,我们将继续深耕数据智能体等方向,推动相关能力在更多行业场景落地,助力企业实现更高效的数据分析与智能决策。


