


企业如何拥抱AI浪潮,实现从“能用AI”到“用好AI”,让AI化身为扎根生产工序、岗位履职、业务运转全过程的“数字工友”,从而实现效率提升和业务流程协同运转,协会联合企业级AI赋能平台UMU继续推出“AI系列知识”专栏之—AI智能演讲训练工具在医疗器械(881144)企业的培训实践。
越来越多的培训团队开始在销售辅导中引入AI。Gartner2026年CSO大会将AI销售辅导列为提升销售生产力的五类AI应用之一,相关研究显示,在销售辅导环节引入AI后,企业新人上手时间平均缩短55%,销售绩效提升21%。
最直接的做法是让通用大模型扮演客户。行业中不少培训团队这样尝试过,效果却不尽如人意。一家头部医药企业经过挑选,选用了UMU的AI陪练工具。本文结合这家企业的实践,比较两种做法在销售辅导中的差别。
企业对AI陪练的三项要求
这家企业的业务遍及全球,产品包括检测仪器和配套试剂,客户以医院(884301)为主。在中国,这家企业有上千名销售,分属4个业务部,负责商务技能授课的老师只有3位。新销售要先通过模拟拜访考核才能独立拜访客户,新产品上市后全体销售要掌握新话术,多条产品线与多种客户类型组合又形成了大量拜访场景,线下演练难以覆盖这些练习需求。
企业引入AI陪练,需要满足三项要求:按企业的拜访流程和客户画像稳定地扮演客户,按企业自己的评分标准评估,并把练习数据沉淀下来供管理者复盘。通用大模型与这家企业选用的工具,差别正体现在这三个方面。
AI陪练能否按企业设定稳定进行
通用大模型扮演客户时进行的是自由对话,没有拜访流程的约束,常常跳过探询、异议处理等关键环节。通用大模型也不了解企业的客户画像和竞品情况,扮演的客户容易偏离设定;同一段提示词换一次练习,难度和走向就可能差别很大。培训团队因此无法保证每位销售都完成了同等难度的练习。
这家企业使用的AI陪练工具,表现受企业在后台的设定约束。每次练习都按企业预设的开场、探询、FAB、异议处理、缔结五个环节推进;AI扮演的客户按后台设定的职位、性格、沟通风格和背景信息回应,价格质疑、竞品比较等异议由企业预先设定,并在对话的适当时机提出。AI会根据销售的回答调整反应,但对话始终在设定的场景内推进。同一个场景无论由哪位销售、在什么时间练习,客户设定和拜访环节都保持一致。
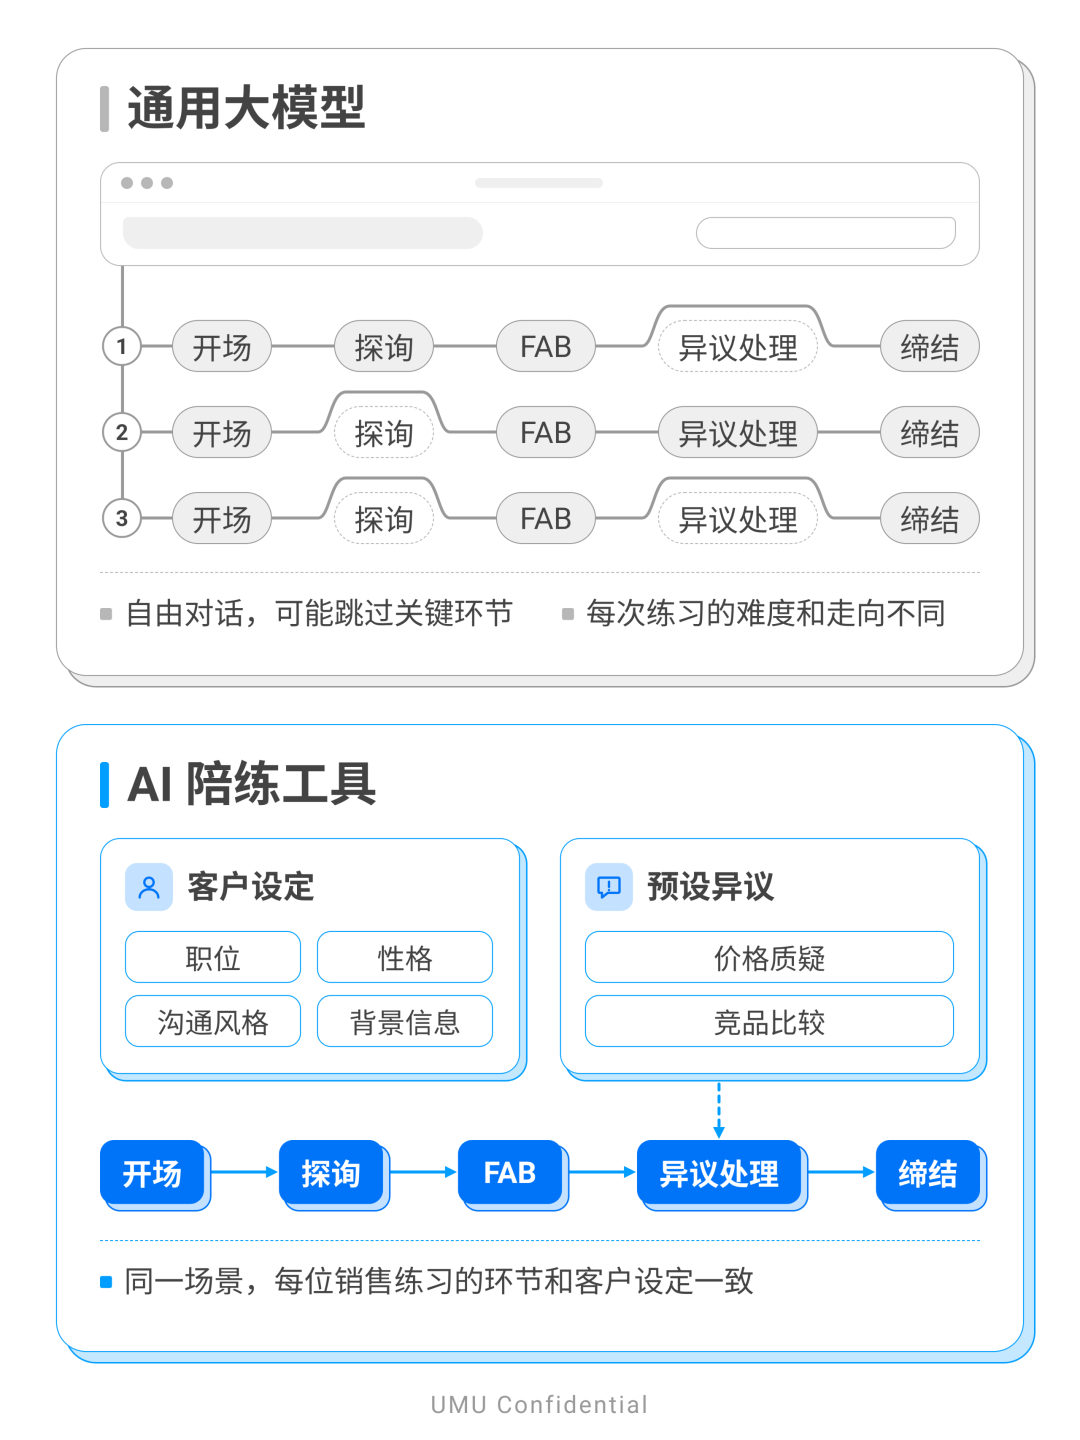
【图1通用大模型的对话走向每次不同,AI陪练工具按企业设定的五个拜访环节推进对话】
AI评分能否按企业标准执行
反馈能否具体到语句
直接让通用大模型评分,得到的反馈多是“表达不错,可以更有说服力”一类的印象式评价,没有分环节的分数,也指不出学员在哪句话上失分。通用大模型的评分逻辑不透明,企业难以让它稳定地按自己的评分表和各环节权重打分,不同学员之间、同一学员前后几次的结果都无法比较。
这家企业在AI陪练工具的后台沿用了线下认证的同一套评分表,AI逐项对照标准打分,评委老师认为评分非常客观、理性。报告按五个环节逐一生成,依据学员实际说出的每一句话:AI对追问单独打分,并区分开放式问题和封闭式问题;在异议处理环节,AI对照后台设定的要点评判学员的回应。一位学员原本预估自己能得95分,AI给出80多分;看完报告后,这位学员发现AI指出了自己平时没有注意到的问题。
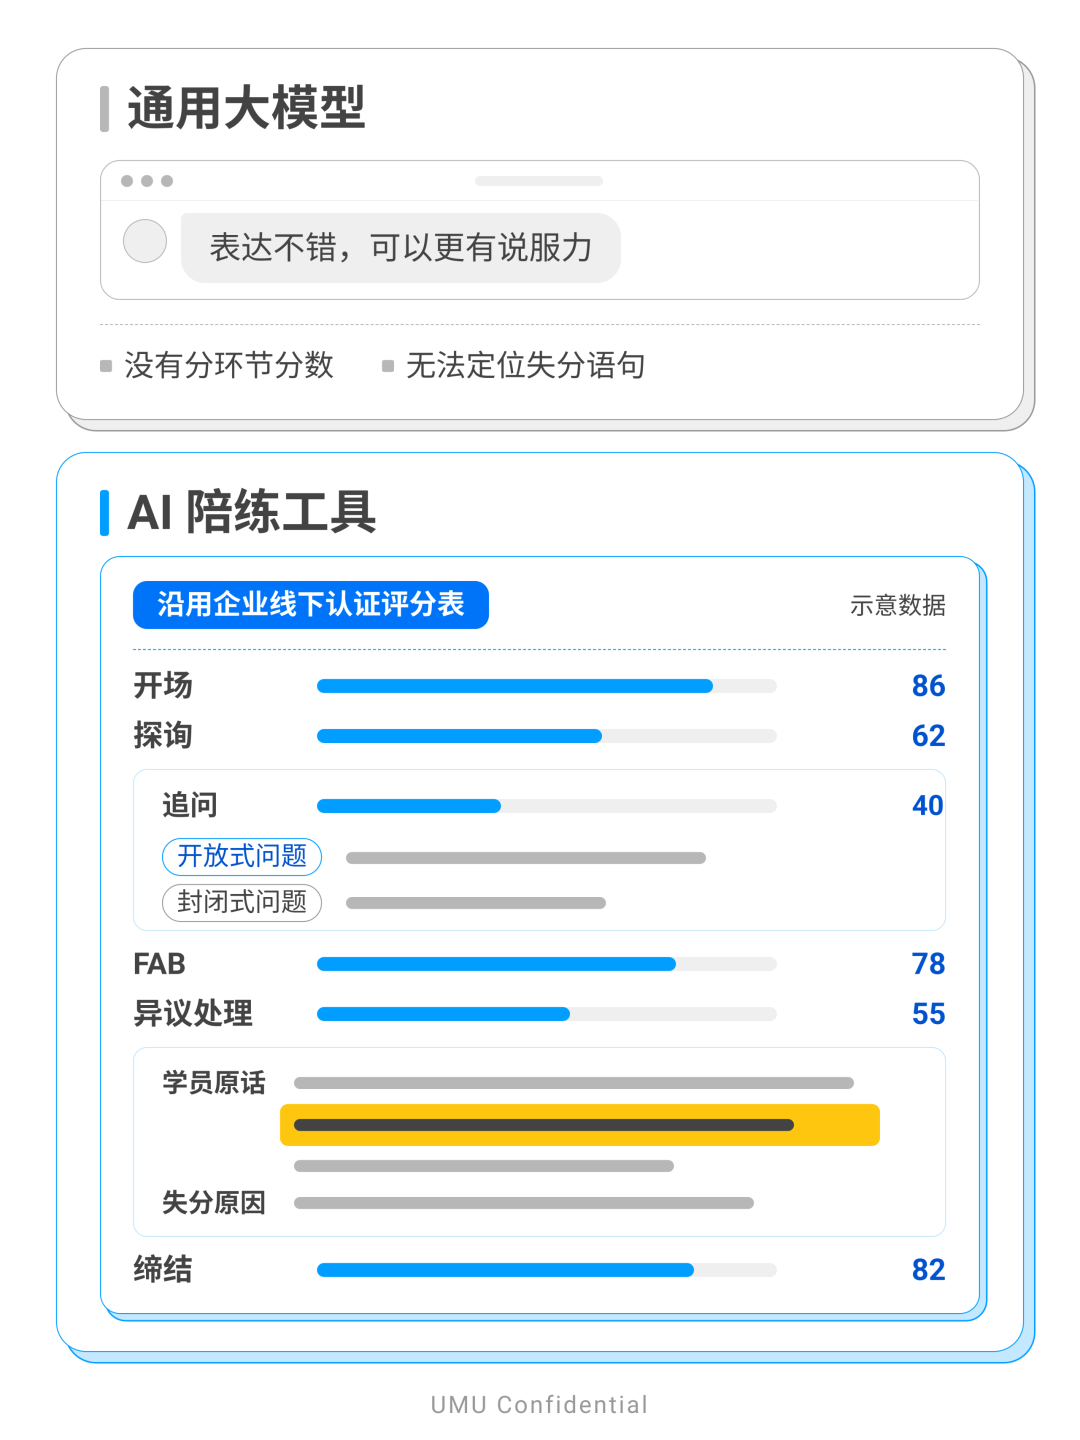
【图2通用大模型只给出整体印象评价,AI陪练工具按企业评分表逐项打分并指出失分语句】
练习数据能否沉淀和汇总
通用大模型的每次对话彼此独立,没有跨时间的进步记录。培训团队和管理者无法汇总多人的练习数据,也就无从得知团队在哪些环节存在共性短板。
在这家企业,学员与AI的完整对话都会保留,各环节得分、细项评分和反馈报告自动归档,汇总到管理者可见的数据看板。培训团队可以横向比较同一业务部内不同学员的得分,也可以纵向追踪同一学员多次练习的分数变化。业务部门负责人从团队数据中发现,学员在追问一项的得分普遍偏低:学员大多只回答AI扮演的客户提出的问题,很少主动追问。项目负责人认为,练习数据能够客观呈现团队在哪个环节存在欠缺,经理可以据此开展有针对性的辅导。
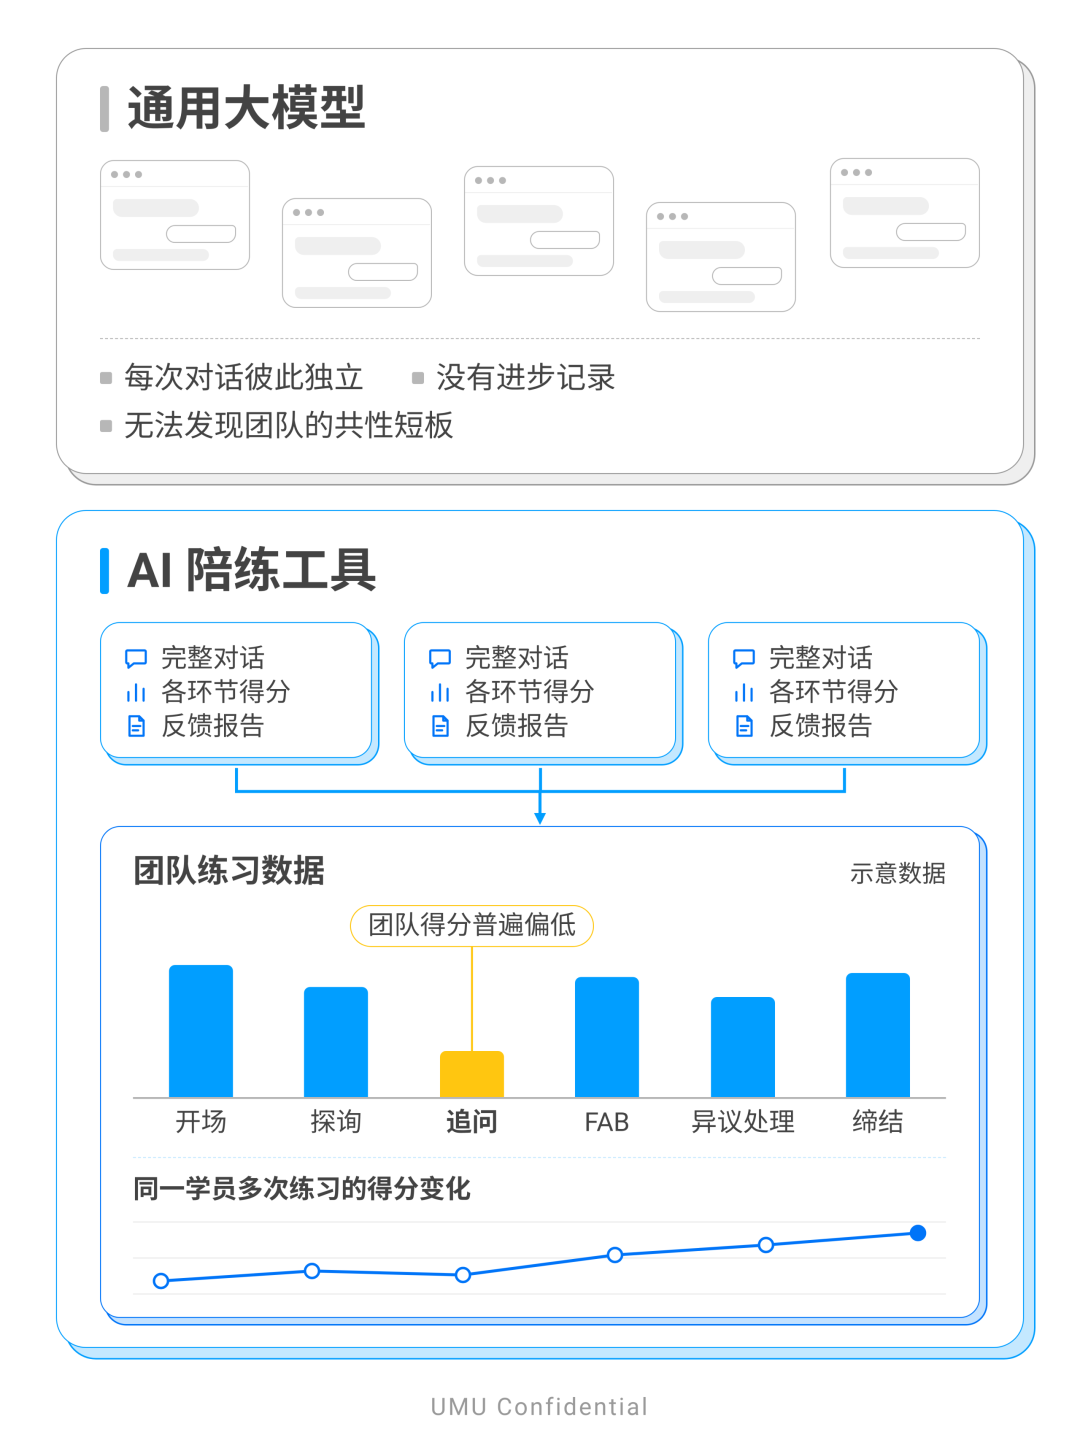
【图3通用大模型的每次对话互不关联,AI陪练工具把每次练习的数据汇总到团队看板】
选择AI陪练工具的三项判断标准
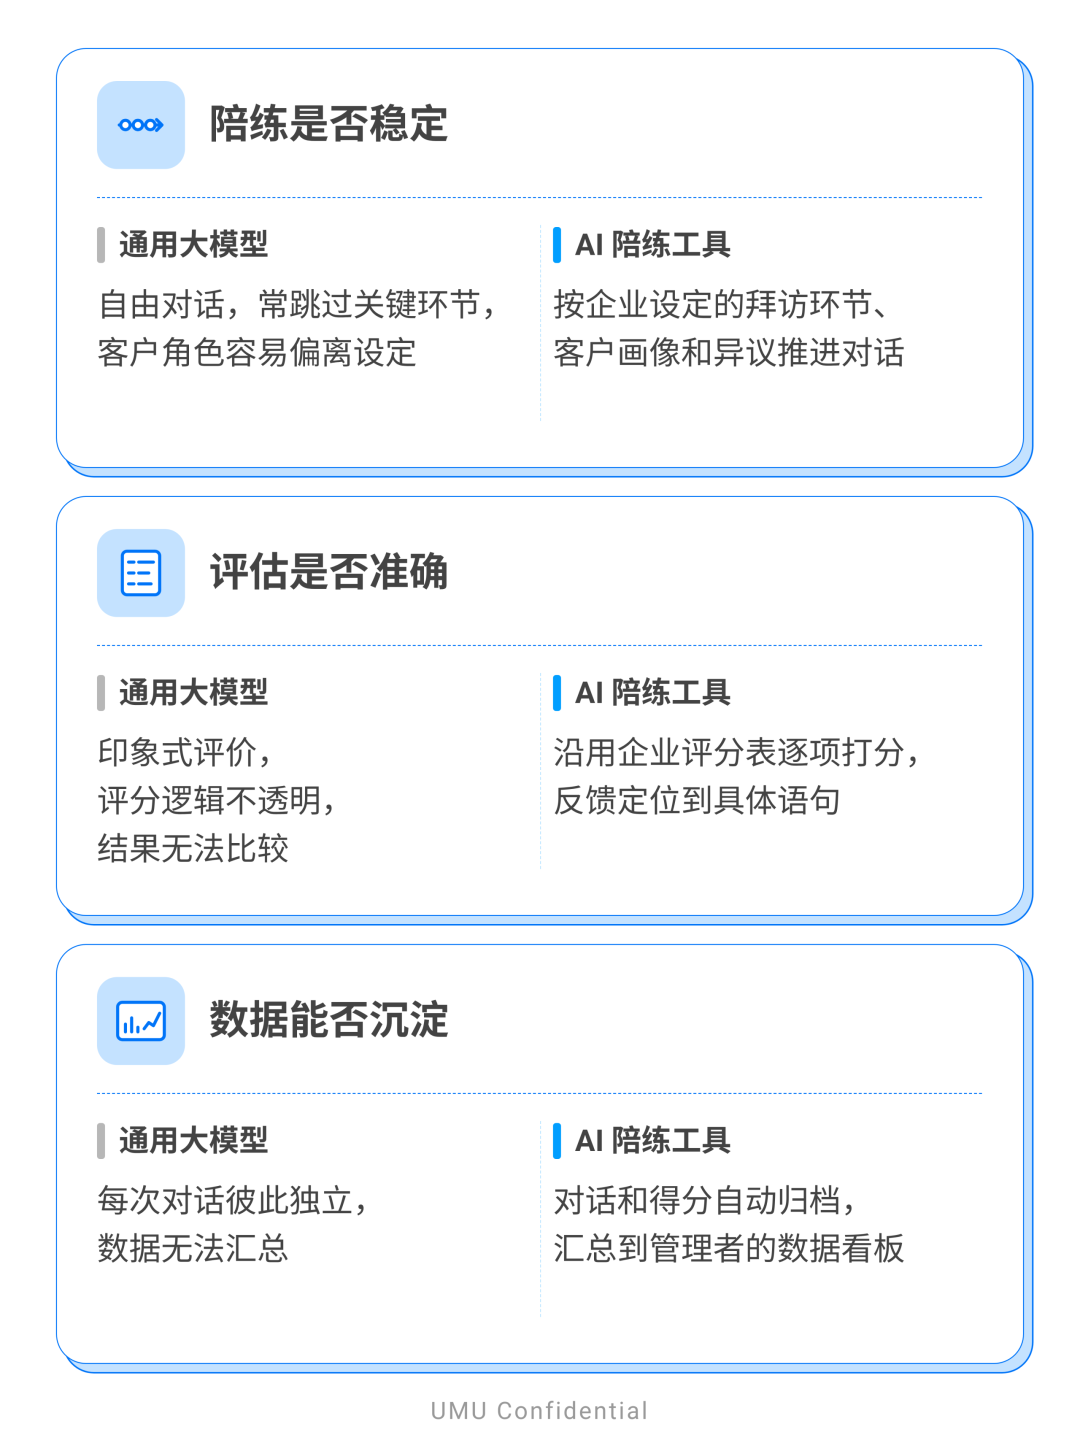
【图4从陪练稳定性、评估准确性和数据沉淀三个方面,对比通用大模型与AI陪练工具】
通用大模型降低了使用AI陪练的门槛,但销售辅导能否获得回报,取决于练习是否可控、评分是否可信、数据是否可用。企业在选择AI陪练工具时,可以从陪练是否稳定、评估是否准确、数据能否沉淀三个方面,检验工具能否适配自己的拜访流程、评分标准和管理需求。


