


今天上班找选题(摸鱼),突然刷到一位网友提问:让豆包生成一张“盒子里有13个鸡蛋”的图片,豆包连续十几次纠错仍未能数清,这是为什么?
小编立刻打开豆包试了试,果然和网友测试的一样,明确告诉豆包生成13个鸡蛋,但豆包只生成了12个。

我不服,换成阿里千问试试,它一边和我说“瞧好吧”,一边生成了10个鸡蛋。
不过千问起码进步了一点,知道13是质数,不是完整的一盒,还在盒子外面放了一个凑数。


再问问腾讯元宝,这次终于对了。元宝直接生成了四张图,有三张的数量都是对的,不过也有一张生成了16个鸡蛋。

这不禁让人产生疑惑,AI已经这么强了,既能下围棋打败人类,又能做出各种各样满足想象力的短剧,那为什么简单的数13个鸡蛋就是不会呢?
01.
AI生图是个偏科生
上世纪80年代,有学者提出了一个“莫拉维克悖论”,是说人工智能(885728)在逻辑推理等“高难”任务上表现优异,却在走路、抓取等“简单”感知运动任务上极其困难的反直觉现象。
事实上,科学家们后续的研究也佐证了这一观点。简单来说,就是AI能拿奥数金牌,却拿不起铅笔。
而在AI生成13个鸡蛋的图片这项任务中,AI满脑子想的是怎么把图片生成得尽量像、尽量美观,却很难把每个鸡蛋数一遍。
其实,研究人员已经发现了这个问题。
英伟达(NVDA)联合两所大学的研究人员,去年在计算机视觉顶级会议CVPR2025发表的一篇论文《Make It Count:Text-to-Image Generation with an Accurate Number of Objects》就专门讲到,AI生图不会数数的根源在于:
身份保持的挑战:13个鸡蛋长得几乎一模一样,甚至相互遮挡,但AI得学会把它们都分清楚哪个是哪个。
全局计算的缺失:人在画一幅13个鸡蛋的画时,自然而然会把鸡蛋的个数数一遍,而AI只收到了生成图片的任务,并不会主动再数一遍鸡蛋。就好比你让一个孩子去洗碗,他就只会洗碗,而不会主动联想到要擦灶台、打扫厨房、扔垃圾。
内部表示未知:AI到底有没有学过数数,到底是怎么数的,如果不认识数字13,那么数13个鸡蛋也就无从谈起了。
此外,13这个数也有点刁钻,只能放一行13个,两行三行四行都会有空缺,AI思考不过来就有点懵了。
02.
让 AI学会数数
既然AI生图不会数数,那么我们教会它不就好了嘛。
没错,这篇论文的研究团队就是这么做的,他们提出了一种生图方法名为CountGen,其核心思路就是利用AI自身的内部信号来检测和修正数量,而不依赖外部的工具。

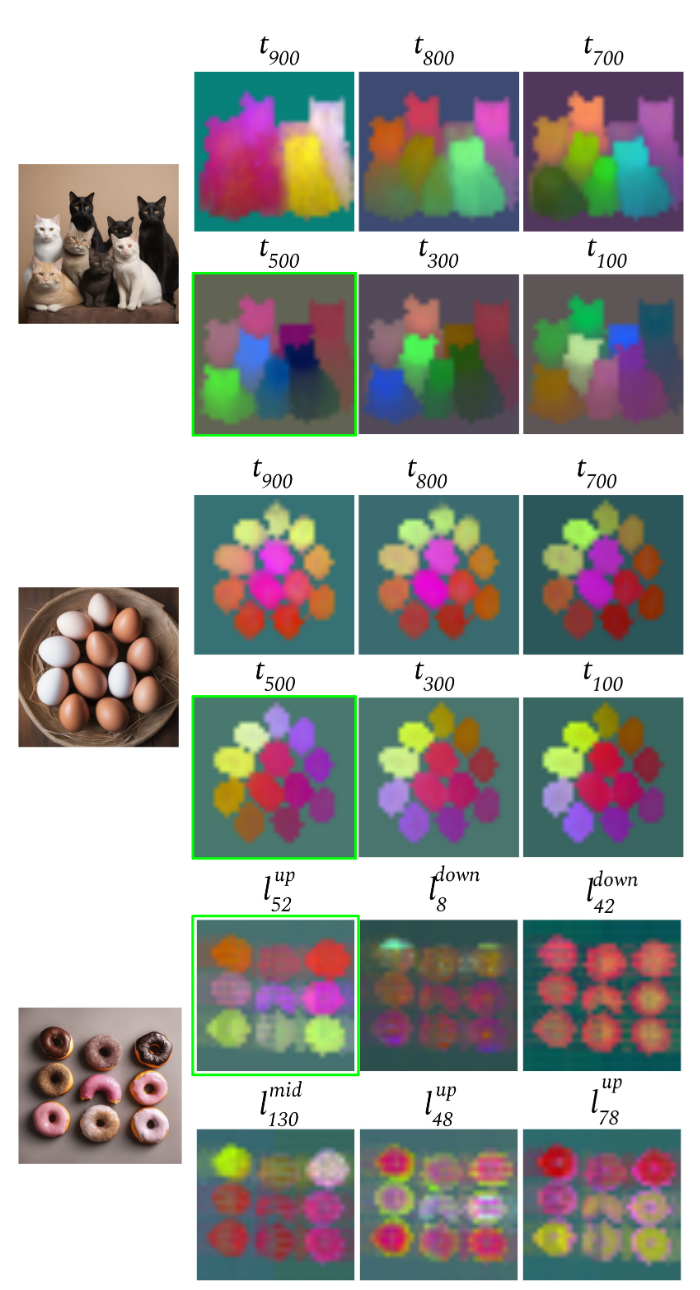
研究人员发现,AI生图过程中其实自带一个“天然计数器”,特定层的特征能区分不同的物体。
即使生成的都是鸡蛋,在注意力图(下图中的色块图)里也会表现为独立的连通区域,而不是糊成一团。这为在去噪过程中实时“数数”提供了可能。

接下来,CountGen要做的就是三步走:
检测与计数:在去噪的特定步骤,提取鸡蛋的注意力图,分离并清点鸡蛋数量。
修正“数量不足”:若检测到数量少于要求,则调用一个轻量级的布局预测模型。该模型基于已有鸡蛋的布局,预测缺失物体的位置和形状,再通过注意力操控引导模型在指定区域生成一个新鸡蛋。
抑制“数量过多”:若数量超标,则通过降低多余区域的注意力响应来抑制其生成。
然后循环往复,一直数到鸡蛋数量是13为止。

最终的结果也证明了训练的成效,相比DALLE3、Reason Out Your Layout、SDXL、Repeated Object SDXL以及Counten Layout+bounded attention等一众生图工具,CountGen生成正确数量的成功率都更高。

03.
我该怎么让AI生图正确数数
上面提到的只是研究成果,接下来要讲的,是我们自己AI生图时,如何让AI更好地数数。
既然豆包不会数,那么我们就要耐心一点,像教孩子那样,详细地告诉它具体怎么做。
比如换个描述语:生成一盒鸡蛋,15个凹槽,其中13个装上鸡蛋,另外两个空着。
豆包这次自动调用了技能,经过将近一分钟的思考和数数,最终生成了正确的13个鸡蛋。

此外,你也可以和它说:生成一盒鸡蛋,每行5个凹槽,第一行装4个,第二行装4个,第三行装5个。
这次的描述更具体,豆包只思考了半分钟,就生成了准确无误的13个鸡蛋。

或者,也可以直接换一个“学过数数”的AI工具,比如ChatGPT就直接准确生成了13个鸡蛋,速度也更快。

此外,你也可以把豆包切换到工作模式,数数的智力就大幅提升了。即使不用详细描述,也能正确生成13个鸡蛋。


