英特尔面向四至六代至强处理器推出推理微服务:自动检测硬件并配置 vLLM 参数
 2026-10-15 00:07:31
 10月14日消息,英特尔今日宣布推出Intel Inference Microservices服务,这是一套面向大语言模型推理的容器化微服务方案,目标是让企业在已有的至强处理器上直接获得经过调优的模型推理能力,无需再花费数天时间进行手动硬件优化。
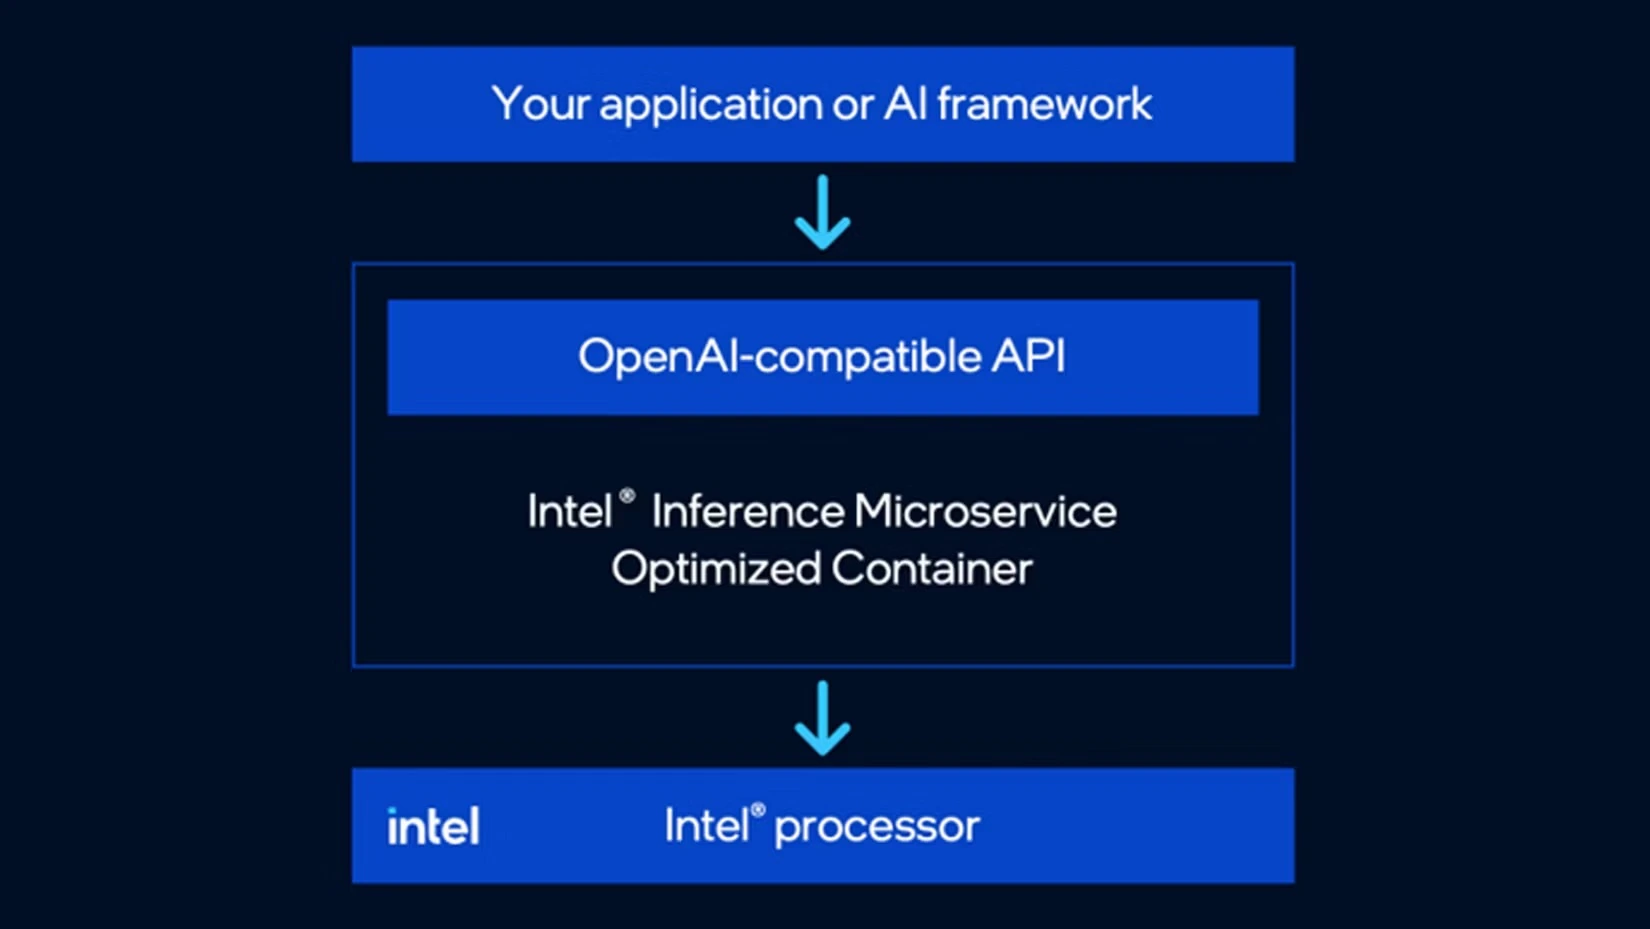
在该模式下,每个微服务都是一个独立容器,通过OpenAI兼容API对外提供单个模型的服务,并在启动时自动检测所在的英特尔处理器型号,应用英特尔针对该模型和该硬件预先验证过的配置参数。
英特尔指出,让大语言模型给出回复并不困难,难的是在既有硬件上稳定、高质量地重复这一过程。精度设置、计算任务在核心之间的分配方式、内存跨NUMA节点的布局,以及推理引擎使用哪些指令集,都取决于模型本身和底层处理器。更换模型,合适的参数就变了;迁移到另一代芯片,参数又需要重新调整。英特尔推理微服务旨在将这一调优过程封装在容器内部——用户选择模型,容器负责选择设置。首批版本基于vLLM引擎,支持BF16精度,可在Docker或Kubernetes1.24及以上环境中运行,硬件要求为第四代、第五代或第六代英特尔至强处理器,建议配置32GB内存。
启动时,容器会检查主机的处理器代数、分配到的核心数量、NUMA节点数量以及处理器内置的加速器。
英特尔特别强调了最后一项:近期至强核心内置了专门用于推理计算的引擎,包括用于矩阵乘法的英特尔高级矩阵扩展和用于周边计算的AVX-512、AVX2及VNNI向量扩展。这些加速器已经存在于用户现有的芯片中,但只有推理引擎知道它们存在并正确配置时才能发挥作用。
检测完成后,容器会选择经过验证的配置档案,解析调优后的引擎参数,缓存权重,并在指定端口启动推理服务。
对于运行特定模型镜像的用户,如果主机未被识别,容器会在启动时报错,而不是静默地以未调优状态运行。基础镜像则默认启用配置回退,在无匹配模型专用配置时,会采用与硬件兼容的通用配置。用户还可以通过命令行查看容器检测到的硬件信息和将要执行的vLLM命令,例如运行detect-hardware或dry-run--format json进行预检。
这并非英特尔首次涉足推理微服务领域。今年9月,英特尔开发者页面已介绍过Intel AI for Enterprise Inference,一套面向至强处理器的开源LLM服务栈,同样基于vLLM架构。此次发布的推理微服务可以视为将这一能力进一步产品化、容器化,并纳入统一的推理接口蓝图之中。
英特尔在新闻稿中将当前版本定位为“迈向英特尔硬件统一推理的第一步”,明确表示这只是一个起点:至强处理器是开始的地方,而不是结束的地方。随着产品组合扩展到英特尔GPU,包括代号Crescent Island的数据中心推理GPU,同一微服务模式将延伸至GPU平台,变化的只是被选中的配置档案,应用程序所面对的接口保持不变。这意味着用户今天基于至强构建的推理工作负载,未来迁移到英特尔GPU时,只需更改部署配置,而无需重写应用程序或重新进行调优。
本次发布还包含一个值得注意的细节:微服务提供的接口刻意独立于底层芯片。一个模型对应一个容器,OpenAI兼容API暴露在已知端口上,运行时自动检测平台并应用英特尔验证过的配置。这种稳定性并非打包层面的技巧,而是因为底层的优化工作被贡献到了开源上游项目中,而非锁定在厂商专属工具包内。
英特尔调优后的容器仍然是一个标准的OpenAI兼容端点,而不是必须采用的SDK。英特尔计划在后续版本中增加Helm Chart、Kubernetes Operator、更多推理引擎和精度支持。目前工具调用和结构化输出功能可作为vLLM的透传能力使用,但尚未被验证为正式支持的能力。每个模型附有各自的许可证,用户需自行确保部署行为符合许可条款。